全部
为什么大模型的Benchmark 不能告诉你,这个 AI 适不适合你的业务?
通用榜单无法真实反映模型业务适配能力,受测试分布、静态快照、分数可优化等局限影响,企业需自建业务评测集,特赞 GEA 优先定义业务标准再匹配模型。
分类
全部
发布日期
2026-10-12
阅读时间
11 分钟阅读
本文技术定位:Benchmark(基准测试)是评估大语言模型综合能力的标准化考试体系,用统一题目横向比较模型的通用能力。它适合研究机构发布排名、技术团队做初步筛选和功能边界对比,但不适合作为企业 AI 选型的主要依据——题目分布与真实业务任务不同、静态测试无法覆盖动态上下文、分数可被针对性优化而难以迁移。Benchmark 衡量模型「能不能做」,业务评估衡量「适不适合做」,两者回答的是不同问题,也不存在稳定的映射关系。企业应从追通用榜单转向构建与自身业务强绑定的私有化评测体系。
每隔一段时间,AI 圈就会涌现一批新榜单:MMLU、HumanEval、MATH、GSM8K、GPQA……这些名字听起来陌生,但背后的逻辑其实很简单——就像高考用统一试卷比较学生,Benchmark 用统一题目比较 AI 模型。
这套机制的出现有其合理性。在大语言模型爆发初期,各家厂商的宣传口径五花八门,「最聪明的 AI」「超越人类水平」之类的说法满天飞。Benchmark 提供了一种相对中性的参照系:至少在这几百道题上,模型 A 比模型 B 的准确率高 3.2 个百分点。对研究者来说,这是有价值的信息。
于是,Benchmark 分数开始成为企业选型的重要依据。技术团队会认真比较 Claude、GPT、Gemini 在各项榜单上的位次,采购决策也越来越多地锚定在「哪个模型榜单排名最高」这个问题上。
问题是,这个逻辑从一开始就有一个没人说破的前提:Benchmark 的题目和你的业务场景,足够相关。
Benchmark 的局限:它考的不是你想要的
理解 Benchmark 的局限,要先理解它考的是什么。
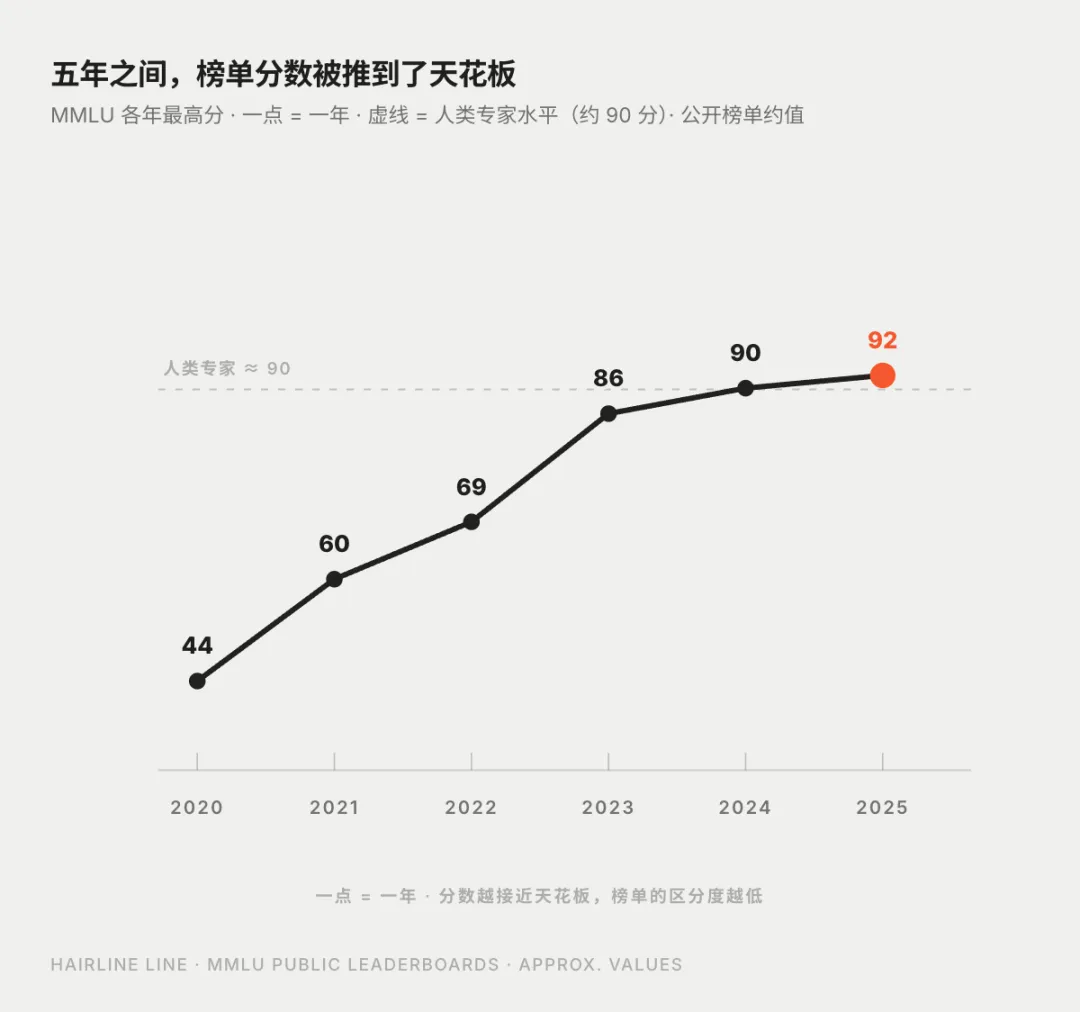
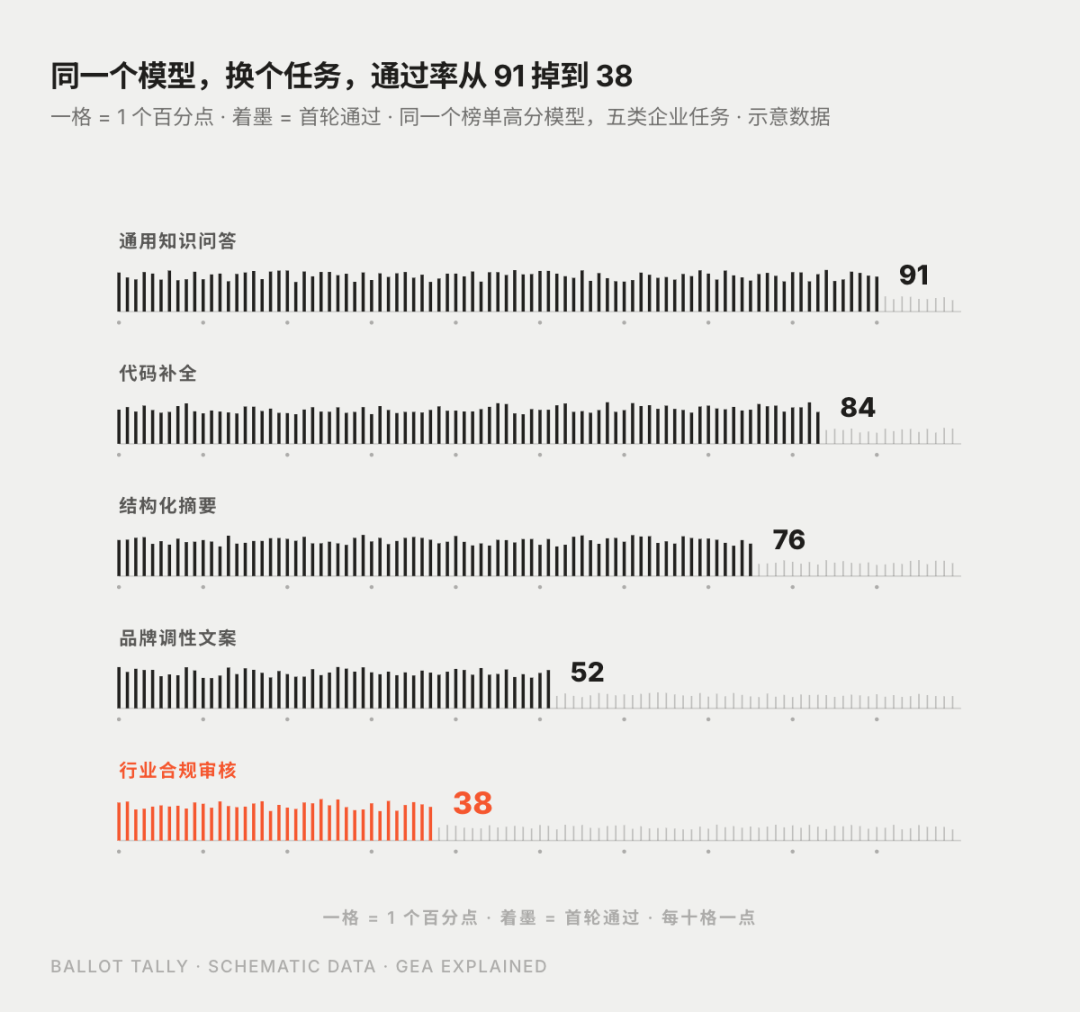
以最常见的 MMLU 为例,它包含 57 个学科、约 1.5 万道选择题,覆盖从数学推理到历史知识的广泛领域。一个模型在 MMLU 上得 90 分,说明它在这 57 个学科里的平均表现不错。但这和「它能不能帮品牌写出符合调性的产品文案」之间,隔着一道几乎无法跨越的鸿沟。
这道鸿沟来自三个层面:
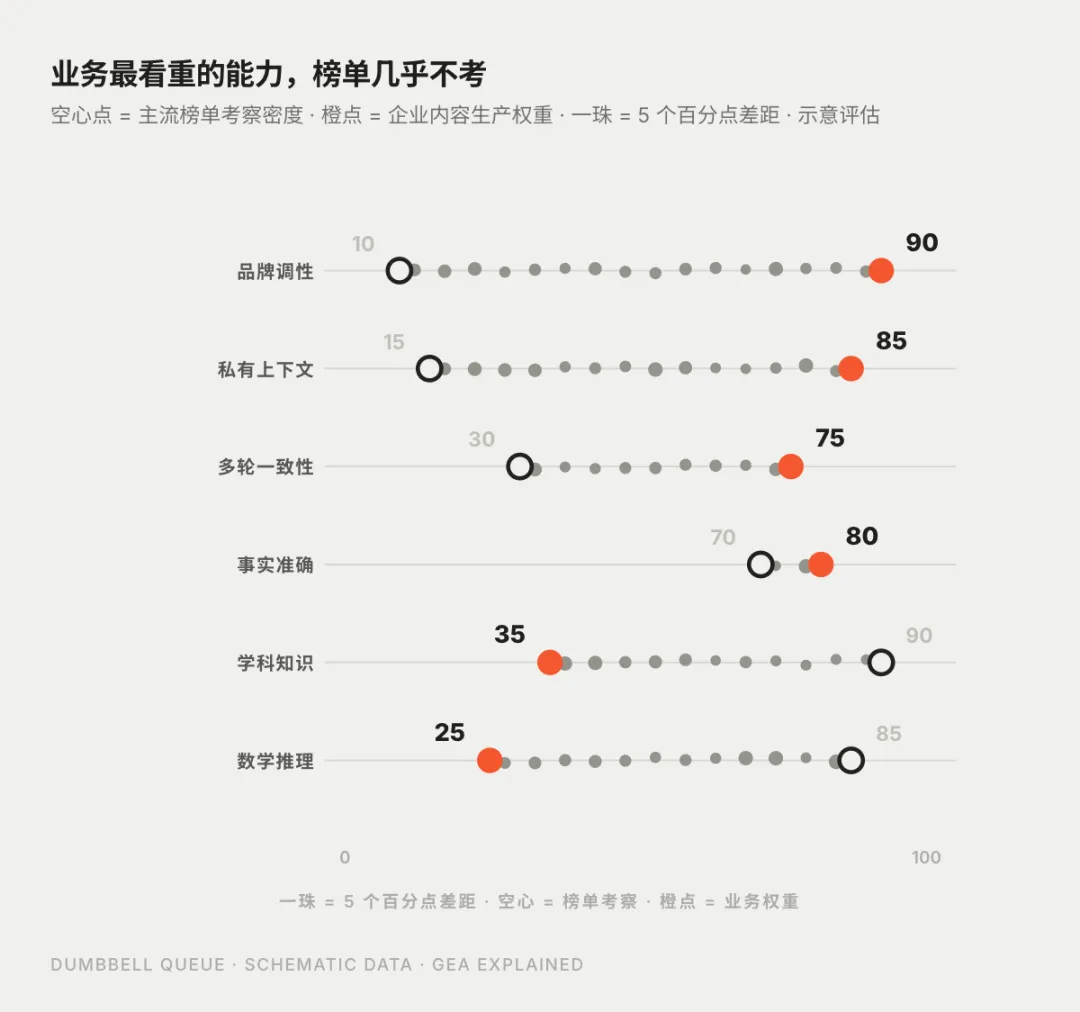
第一,测试分布和真实任务不同。Benchmark 题目大多来自教材、竞赛和学术数据集,语言风格、任务类型和企业日常内容生产的需求差距悬殊。一个在 MATH 上拿高分的模型,未必能准确理解「我们品牌的语气是温暖但不过于亲密」这种软约束。
第二,Benchmark 是静态快照,业务是动态上下文。标准化测试的每道题都是独立的,不依赖上下文。但真实的企业 AI 任务——比如基于历史内容风格生成新文案、根据品牌手册约束输出——要求模型持续处理大量私有信息,并在多轮交互中保持一致性。这种能力,Benchmark 基本不考。
第三,分数可以被优化,但不能被迁移。业内有个共识:随着 Benchmark 越来越出名,各家模型厂商都会针对性地强化对应数据集的训练表现。一个模型在 HumanEval 上的高分,可能部分来自训练数据的泄露或针对性优化,而非真实的代码能力提升。企业拿这个分数做选型,信噪比其实在持续下降。
企业真正需要评估的是什么
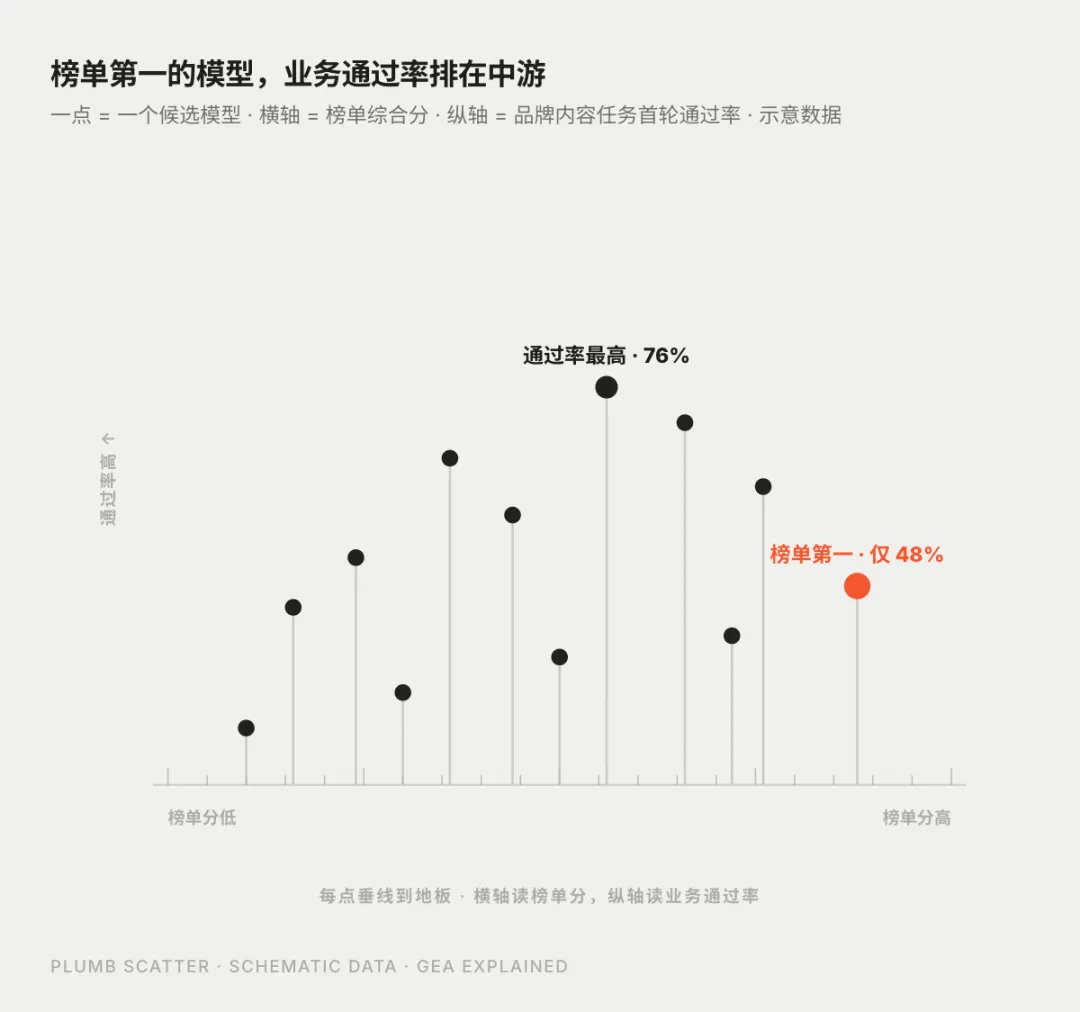
如果 Benchmark 回答的是「这个模型有多聪明」,那么企业真正需要回答的问题是:「这个模型在我的场景里,用我的数据,解决我的任务,能达到什么质量?」
这两个问题的答案,几乎不存在稳定的映射关系。
以内容生产场景为例。一个品牌的内容规范文档里写着「不用‘领先'和‘赋能'这类词汇」「短句为主,每段不超过 4 句」「中英文混排时英文首字母大写」——这些约束不会出现在任何 Benchmark 里,但它们直接决定了 AI 输出能不能进入生产流程。
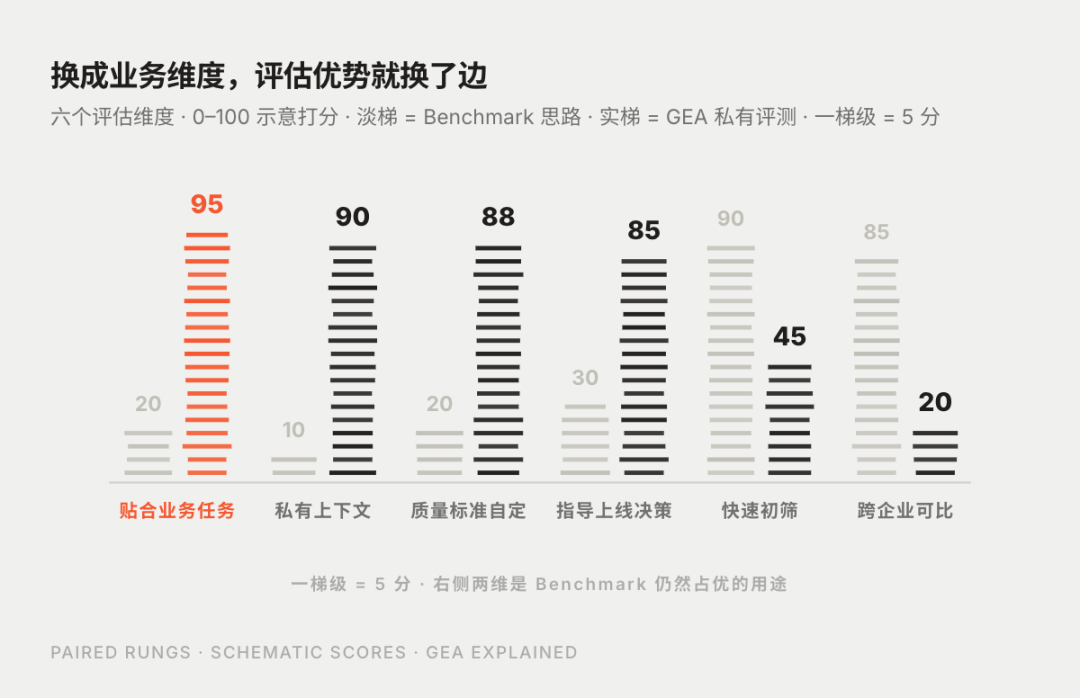
评估一个模型是否适合企业场景,更有效的方法是私有化评测(Private Evaluation):把真实历史任务、真实数据、真实评审标准组合成测试集,用自己的质检流程打分。这个过程比下载一份榜单慢得多,但给出的结论是可信的。
特赞科技 Tezign 在构建 GEA(企业级智能体)时,把这个逻辑内化到了产品设计里:模型本身是可替换的组件,但上下文系统(Context System)——企业的品牌规范、历史内容、风格偏好——才是真正决定输出质量的关键变量。再好的基础模型,没有对应的上下文输入,在企业场景里都只是一个平均水平的答题机器。
这也意味着,企业真正需要的不是去追一份又一份通用榜单,而是建立一套适合自己业务场景的 Benchmark——把真实业务任务、真实历史数据、真实质检标准组合成自己的评测集。这件事没有捷径,但值得投入,因为它直接决定了 AI 能不能从“demo 好看"走到“生产可用"。这也正是特赞在持续深耕的方向:把不同行业、不同内容生产场景的评测方法论沉淀成可复用的能力,帮助企业构建属于自己的、和业务强绑定的评测体系。
在 GEA 里,「评估」意味着什么
GEA 在处理这个问题时,走的是一条和 Benchmark 驱动选型完全不同的路径。
不是先选模型,再搭流程;而是先定义任务和质量标准,再决定哪个模型放在哪个环节。
以一个典型的内容生产任务为例:品牌 A 需要每周生产 30 篇面向不同地区消费者的产品介绍文案。GEA 的评估起点不是「哪个模型的语言能力最强」,而是:这 30 篇文案里,哪些变量是固定的(产品信息、合规要求),哪些变量是动态的(地区偏好、时效性表达),哪个环节需要人工审核,审核的维度是什么。
把这些问题想清楚之后,评估就变成了一个数据问题:拿品牌历史通过质检的文案作为参照,测试不同配置下 GEA 的输出和历史通过率之间的距离。这个距离越小,这套配置就越适合这个品牌的场景。
这是一种务实的评估方式——不看模型在标准化题库上的表现,看它在你的生产标准下的合格率。
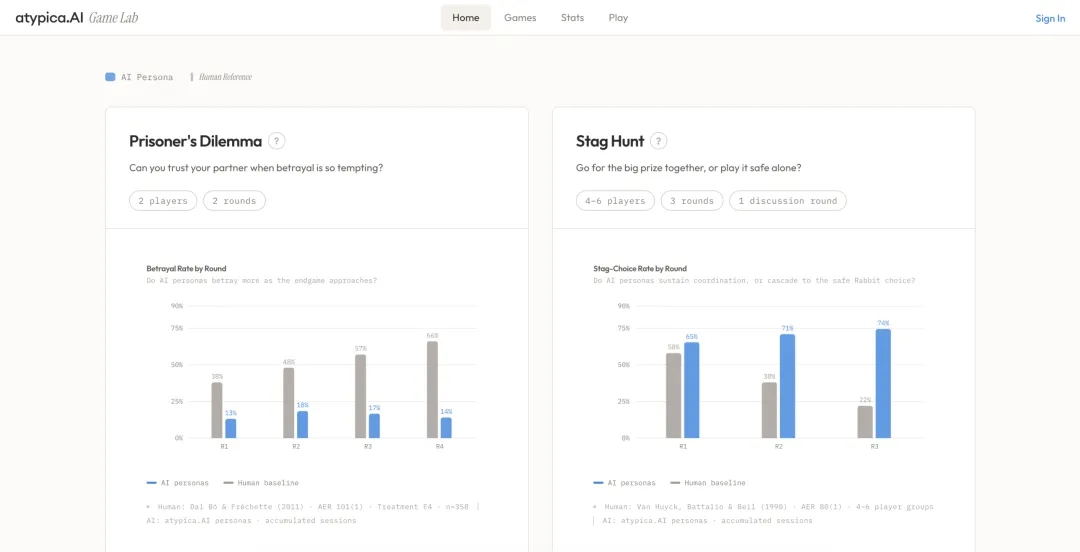
特赞的GameLab是这种评估思路的一个典型实践。GameLab 要回答的核心问题很直接:AI Persona 的模拟准确吗?怎么证明?它的做法不是去查通用榜单,而是让真人和 AI persona 做同样的经济学行为实验——从囚徒困境、最后通牒游戏到电车难题,目前已上线 10 个实验、累计数百场次。通过对比两者在同一博弈中的决策数据,判断 AI Persona 的模拟是否到位:数据高度接近说明校准有效,偏差大则回到数据重新训练。这个基准本身就是从业务场景(AI Persona 仿真)中长出来的,而不是从通用题库里搬来的。用真人行为数据作为基准、持续校准 AI 表现,正是“适合业务场景的 Benchmark"从理念走向落地的具体形态。
Benchmark 的边界与正确用法
说到这里,并不是要否定 Benchmark 的价值,而是要把它放回到它适合待的地方。
Benchmark 适合做的事情:初步筛掉明显不达标的模型,在功能边界(是否支持长文本、是否支持图文理解)层面做快速对比,作为技术研究的参照指标。
Benchmark 不适合做的事情:作为企业 AI 选型的主要依据,判断某个模型是否适合特定业务场景,替代私有化评测流程。
对于企业来说,看 Benchmark 的时间如果超过构建自己评测集的时间,这个优先级本身就值得重新考虑。真正适合你的 AI 配置,不在榜单第一名里,在你自己的数据和任务里。
分类
全部
发布日期
2026-10-12
阅读时间
11 分钟阅读
相关推荐
AI Workflow 无法搞定的复杂业务,长程智能体是如何解决的?
Harness 的保质期只有半年?企业 AI 产品为什么不能一劳永逸