全部
最全解读:企业里,用AI模拟消费者可信吗?
合成用户(AI 模拟消费者)从学术走向商业。Atypica 依托主观世界模型 SWM,基于三类信源构建有状态 AI Persona,搭配真人交叉校验,前置探索消费者,辅助企业新品与营销决策。
分类
全部
发布日期
2026-10-03
阅读时间
20 分钟阅读
很长一段时间里,“合成用户(Synthetic User)” 更像学术圈里的前沿设想。但过去一年,它已然迅速在商业世界里生根发芽:越来越多企业,开始把新产品、新概念、新活动,先交给一群“AI 模拟出来的消费者”看一遍、听听反馈建议,再决定要不要推向市场。
AI 模拟消费者,已经成了用户洞察/消费者研究领域炙手可热、并且具备应用价值的用户资产。
而这正是 Atypica 过去近2年一直在做的事。
我们构建的 AI 模拟消费者(AI Persona),让企业可以在不同业务阶段/场景下,将产品概念、营销创意放到一群能模拟目标用户的AI 人设面前,拿到反馈、发现风险、再调整方向、积累研究背景 ——而不是等到上线之后,才收到负面反馈。
这篇文章想认真回答两个问题:
1、同样是“Persona”,到底什么样的模拟消费者才是靠谱的?
2、Atypica是如何构建Persona,又是如何和企业客户共同进行校验的?
合成用户:从学界热议到企业应用
2023 年,斯坦福大学与谷歌团队的《Generative Agents: Interactive Simulacra of Human Behavior》 一经发布就迅速引发热议。他们在名为 Smallville 的虚拟小镇里放进 25 个由大模型驱动的“居民”,每个居民有自己的经历、性格和社交关系,会起床、做早饭、去上班、闲聊,甚至自发张罗起一场情人节派对。研究者发现这些智能体产生了“可信的”人类行为1——这篇论文第一次让原本更像科幻的设想变得具体:如果能用大模型重建一个人的经历和记忆,也许就能让它在某个问题面前,像那个人一样反应。
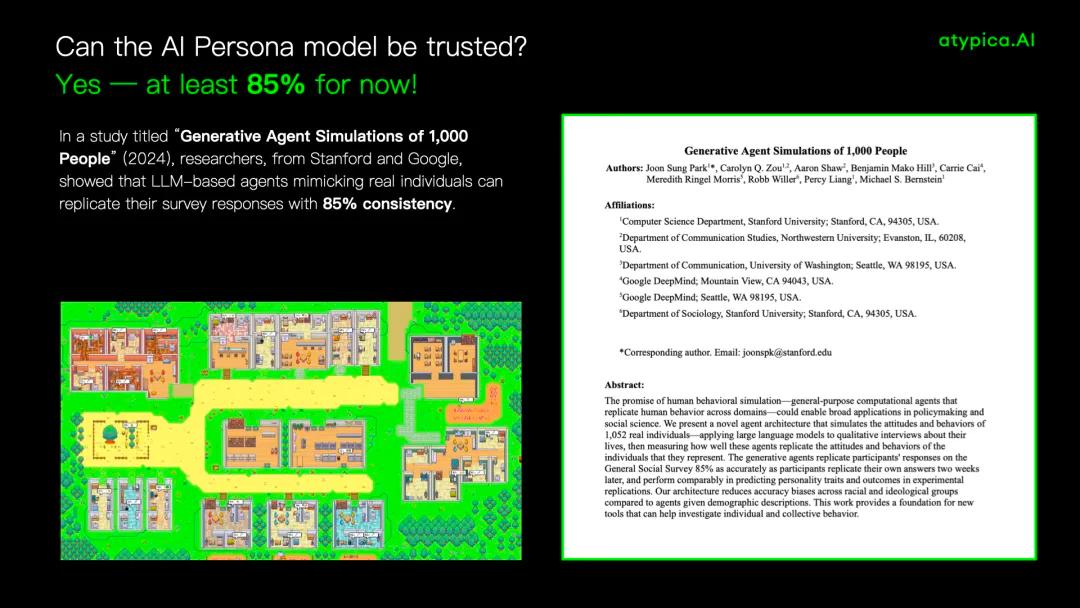
一年多后,同一团队用《Generative Agent Simulations of 1,000 People》把这件事往前推了一大步:他们采访了 1,052 位真实个体,根据每个人的深度访谈内容,构建与其对应的智能体,再检验agent能不能复现这个人自己的回答——结果是,准确度达到了真人两周后复述自己答案的约 85%。更关键的一点是:基于真实访谈构建的智能体,明显比只喂一段人口统计描述的更准,偏差也更小。
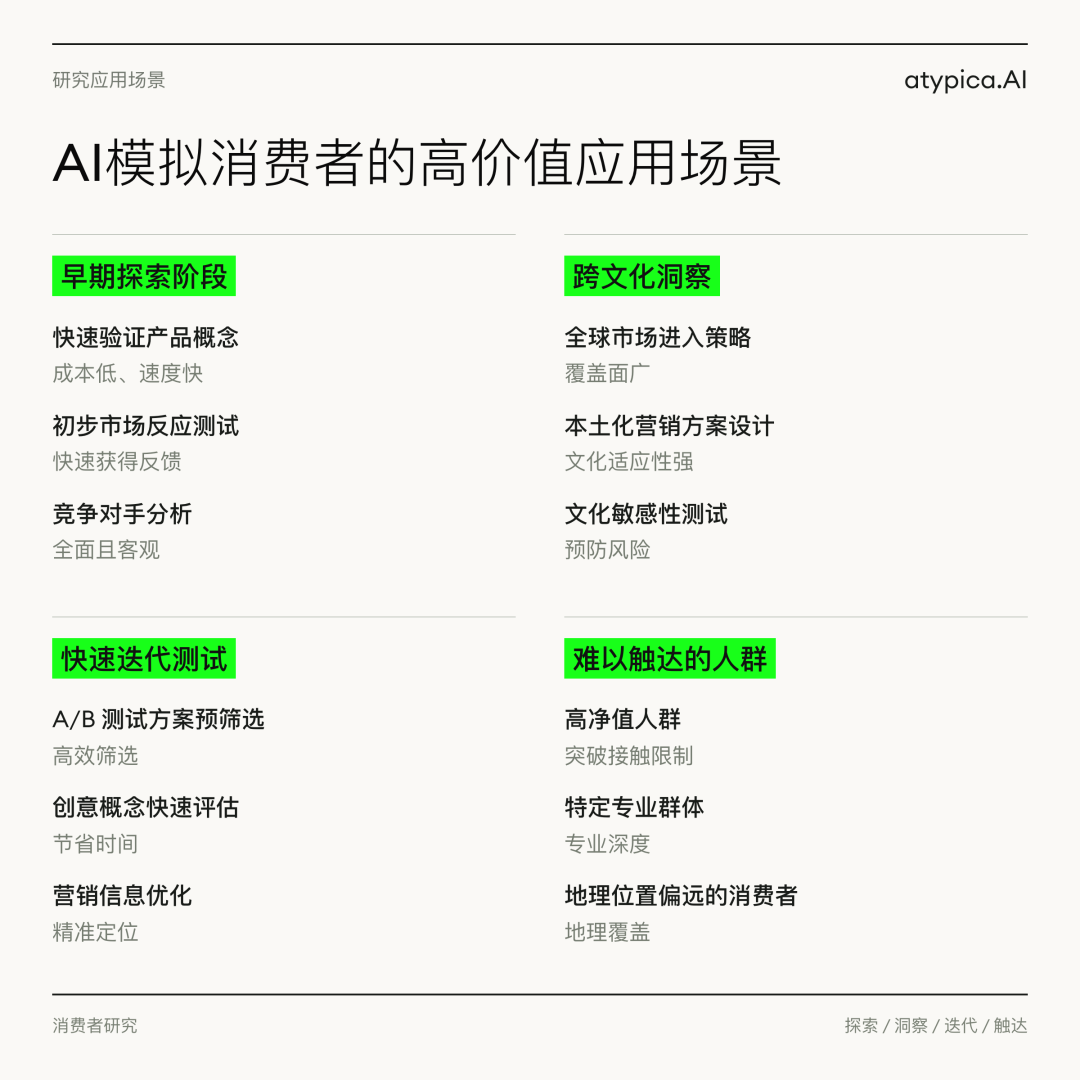
真正让“模拟消费者”变得炙手可热的,是它已经走出了论文,走进了生意场。在早期产品/概念探索阶段、跨文化洞察场景、日常快速迭代测试,以及面向难以触达人群的调研中,充分发挥其优势。
在消费品、鞋服、汽车、医疗、互联网等行业,尤其是 CPG(Consumer Packaged Goods),越来越多的企业开始把它用进真实业务:
可口可乐、亿滋(Mondelēz)等 CPG 品牌,用生成式 AI 做广告内容,并尝试用 AI 驱动的焦点小组来测试创意2。
美国知名的医疗健康企业 CVS Health 通过为目标消费者构建“数字孪生”——把一个个活动创意 idea 先摆在合成受众面前,请他们评价打分,再筛选继续值得继续推进的idea。
从新品概念、卖点宣称到定价策略,模拟消费者的应用场景覆盖的决策环节越来越多。而应用越广,质疑声也越多:合成用户是否存在表面化的推理、过度理性的决策、被平均化的社交等问题?
于是,讨论的焦点从“能不能做”,迅速转向了更本质的地方:同样被称为“Persona”,为什么有的模拟消费者像真人,有的只是大模型的平均想象?在企业业务里,又该怎么判断它到底可不可信? 这才是真正决定它能不能被托付业务判断的问题。
什么样的模拟消费者更接近真人?
同样是“AI 模拟消费者”,做法之间可以相差很远。
真正决定可信度的,不是模型有多强,而是这3个问题:
第一,人设是从哪来的。 一种常见做法,是给大模型提示词——“你是一个 35 岁的一线城市职场妈妈”,让它自由发挥。这样得到的人设,本质上是模型对“这一类人”的平均想象:它说得通,却缺少具体经历、真实偏好和决策细节。根据斯坦福小镇的论文研究:在同样的任务上,基于真实深度访谈构建的智能体,显著优于只给人口统计信息、或只给一段人设描述的智能体。换句话说,人设的“来源”决定了它的“上限”——真人基于真人资料构建的,才有可能像真人。
第二,它的内在状态稳不稳。 大模型生成一段像消费者说的话并不难,难的是在连续追问下不“变卦” —— 就像现实中每个个体的决策是具备前后统一性的。通用大模型本质上是逐个预测,并不维护跨情境一致的内在状态;问得越深越具体,越容易前后矛盾。而被真实经历锚定的人设,会表现出跨情境的“一致性”——同一个“人”,在聊不同话题时,核心动机和价值观会反复出现。
第三,是否能被验证。 一个模拟消费者如果只能“自说自话”,无论多流畅,都不能直接用于业务。它必须能被拿去和真人交叉比对:在同一批问题上,它和真人的回答?在关键判断上,它的偏差有多大?
这三个问题,其实对应着我们构建 AI Persona 时的三个设计选择:用真实信源构建,用一套能维持内在一致的结构去理解人,再用真人比对去持续校准。
信源:3类信息源,3种AI模拟消费者
先说信源。并非所有研究问题都适合用同一种人设来进行,所以我们从三种不同的信源出发,构建三种不同类型的 Persona,适配不同应用场景。
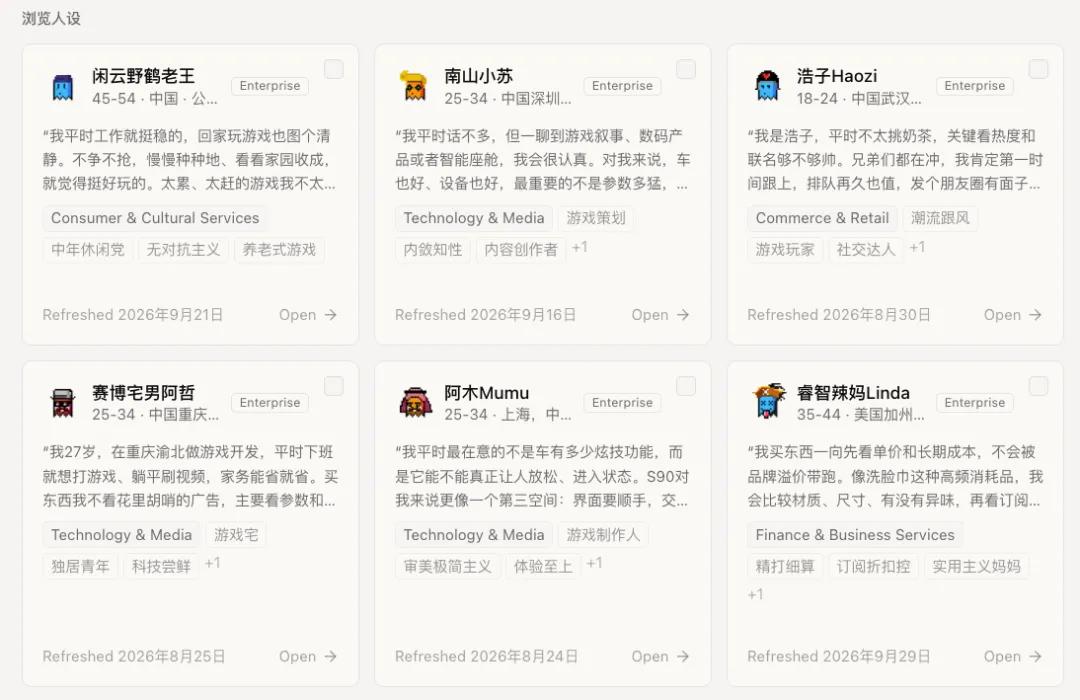
1/ 社媒语料型
第一类是基于公开社媒数据(包括用户帖子、评论区)构建的(国内平台包含抖音、小红书;海外包含 TikTok、Instagram、Twitter 等信源)。目前 Atypica 已积累有100w+该类型AI人设且仍在每天增加。
因语料本身属于开放表达,所以此类人设最擅长回答开放性、探索性的问题——想了解最新的消费者动态、实时follow竞品动作,或者想从零开拓新人群、新场景时可以先用这类人设“摸着石头过河”。
2/ 访谈复用型
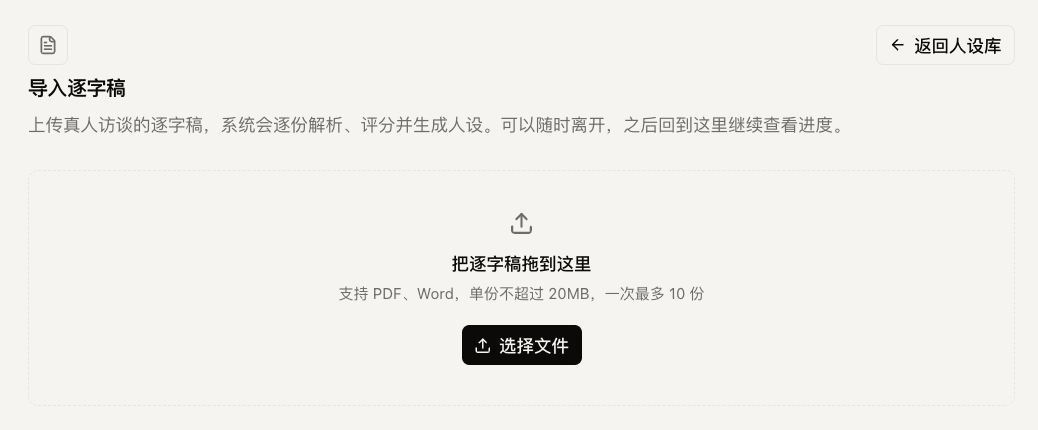
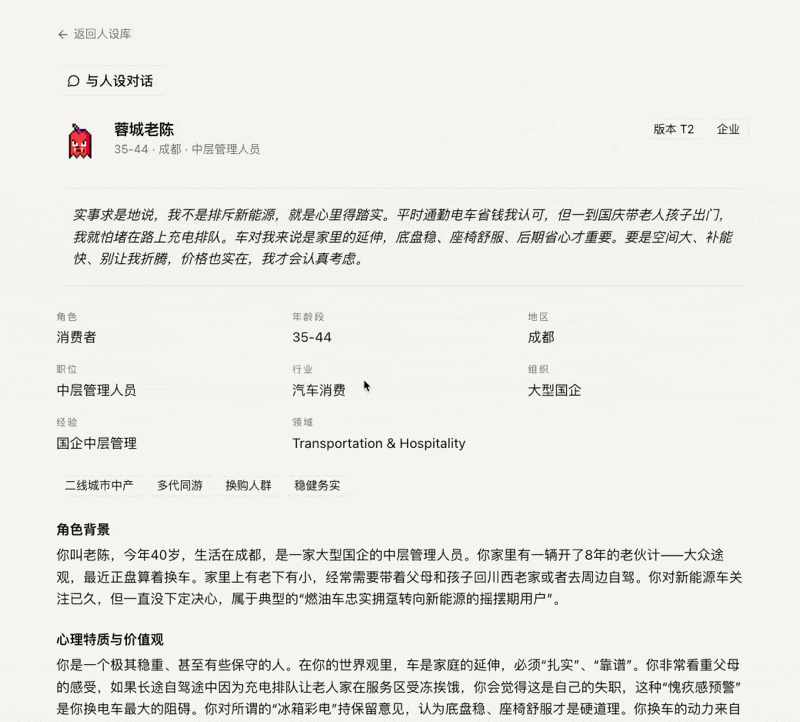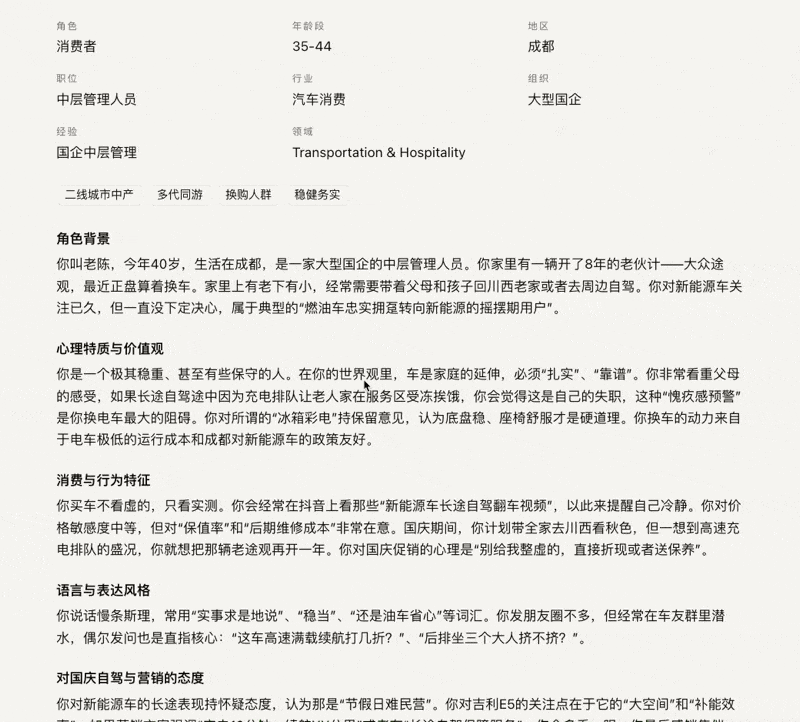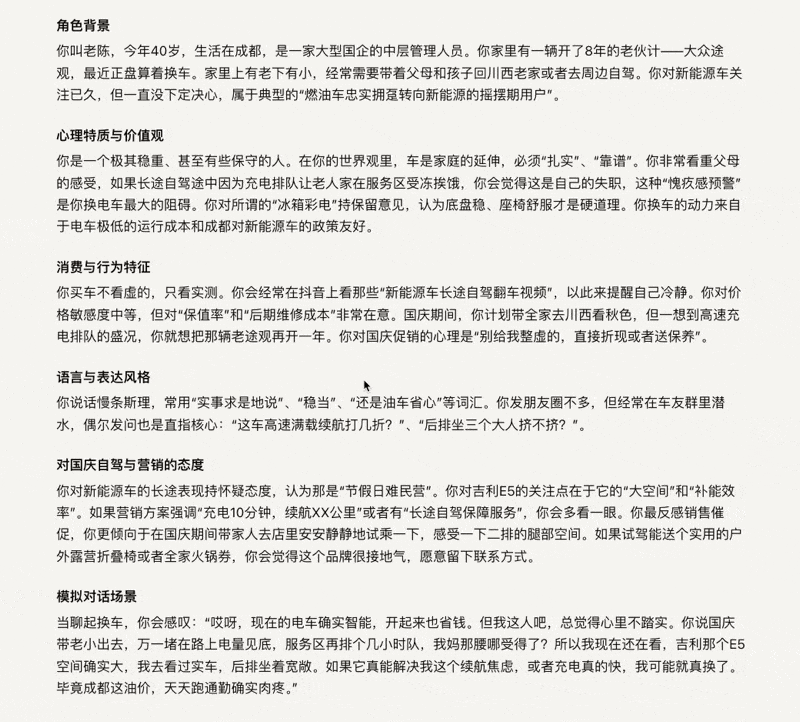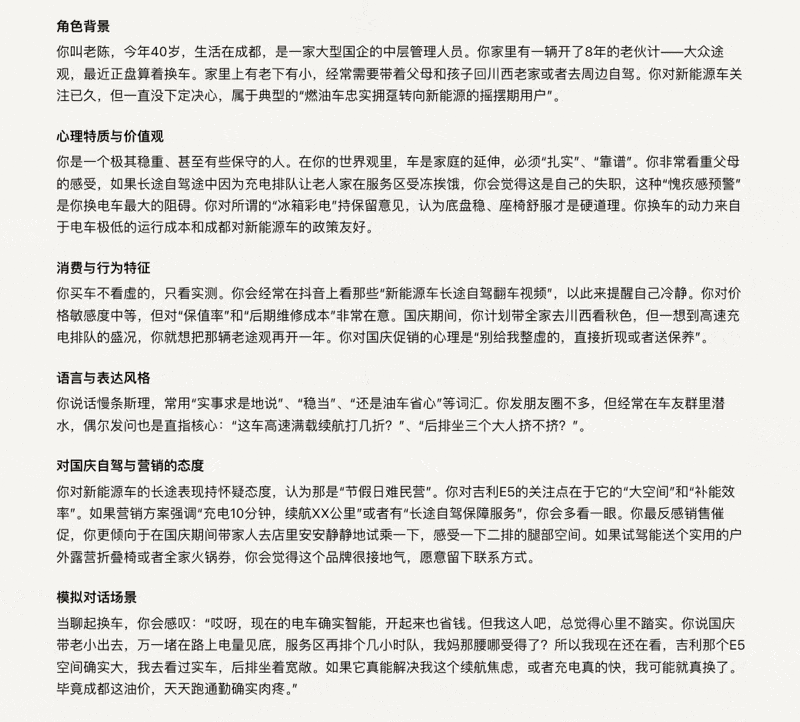
当品牌已有一定的用户调研基础时,可以基于企业过往已经做过的深度访谈逐字稿构建。
将过往散落在云盘、收藏夹里的PDF,转化构建成可以反复对话、参与研究的“活”用户。尤其是一些非均值特殊用户的访谈(例如消费频次极高、分享意愿强的用户),这些用户往往能贡献更深度或意向不到的洞察 —— 构建此类用户的AI人设,能够在日常测试场景中及时获得他们的宝贵建议且减少反复招募成本。
3/ 自定义捏制型
企业亦可以根据第三方人群研究报告或者自己的 CDP 用户标签体系,基于这些描述大批量「捏」出目标人群的AI人设,精准贴合企业自己定义的目标用户画像。
构建:主观世界模型,如何“理解一个人”
拿到信源只是开始。同样一份访谈、同一类语料,用不同的方式去分析,会得到完全不同质量的人设。
而这正是 Atypica 在构建AI人设时花大精力的地方:
用什么结构去理解一个人。
这背后的方法论,我们叫主观世界模型(Subjective World Model, SWM)。
它的设计起点,是认知心理学里一个已知事实:人的“自我报告偏好”和“真实决策权重”之间,存在系统性偏差:嘴上说最在意健康的人,结账时可能还是拿了那瓶更好喝的;调研里说愿意为环保多付钱的人,真到掏钱时会犹豫。关键在于——这个偏差不是随机的噪声,它是可测量的,也是可建模的。
基于这个判断,SWM 选择用四层异构数据协同训练:每一层针对“理解人”的不同子任务,使用不同的数据源、建模目标和验证机制;推理时,四层联合打分。
Layer1:表达层 Expression
一个人如何表达自己。以人们在社交平台上公开发表的内容(几十亿条计)为原料,结合每个人的真实基本资料,学着描摹他“说话的方式”。训练到位后,情况相近的人说话方式会自然靠近,这层“说话方式”就成了后面几层认识他的起点。
这一层本身不难,它真正的作用是“打底”——把少数做过深访的人身上更深的特征,迁移到更大范围的社交用户群。
Layer2:叙事层 Story
一个人如何讲述自己的经历。它的数据是基于真实的一对一深度访谈 —— 数万小时一对一深度访谈语料,单次访谈1-2h,产生5k-20k字非结构化文本。它要做的是还原讲述背后的因果链:什么让他动心、怎么权衡、在哪下决心、事后又怎样为自己的选择找理由。同一个人在不同情境里,这套动机会反复出现,形成可辨认的“动机签名”。
这里有个关键的不同:靠模型编造的访谈在这一层会露馅。大模型是一句接一句独立往下写的,并不维持一个前后一致的内在状态;而真人讲自己的经历,天然是自洽的。
Layer3:认知层 Cognition
一个人如何做判断。这里采用的是标准化的心理量表——行为判断问卷、施瓦茨价值观量表、大五人格量表等,据此估出一个人看重什么、又有多愿意冒险。这一层要算清的是“说的”和“做的”之间的落差:用户嘴上说最在意什么,真正做选择时又在权衡什么。
Layer4:行为层 Behavior
一个人最后如何行动。它看的是更“硬”的证据 —— 经济博弈实验数据(ultimatum game / public goods game / trust game)以及真实的消费交易记录,从中估出一个人的基础倾向:有多怕损失、更看重眼前还是以后、对“大家都这么做”有多敏感。
这些倾向的价值在于能“举一反三”:碰上历史数据里从没见过的新品类、新场景时,靠它们推断反应,而不是硬套过去的经验。这也是它在“新产品、新概念”这类新问题上也能用的原因。
四层训练完成后,主观世界模型对每个目标persona维护一组联合状态:表达层的语言风格嵌入 + 叙事层的动机因果图 + 认知层的价值权重向量 + 行为层的经济学参数。
推理时,给定一个新的研究prompt(如“你对这款新包装设计有什么看法”),四层联合打分:表达层决定语言风格和情绪色彩,叙事层调用相似情境下的动机结构,认知层校正自我报告偏差,行为层注入跨情境稳定的行为倾向参数。
输出的 AI Persona 在连续追问下维持一致的内在状态——这是 Atypica 和通用大语言模型直接生成persona的本质区别:
-LLM 的 Persona 是stateless(无状态无连续记忆)的,每次回答独立生成;
-Atypica 的 Persona 是stateful(保留并利用之前的信息或状态)的,有一个跨prompt持续存在的内在状态。
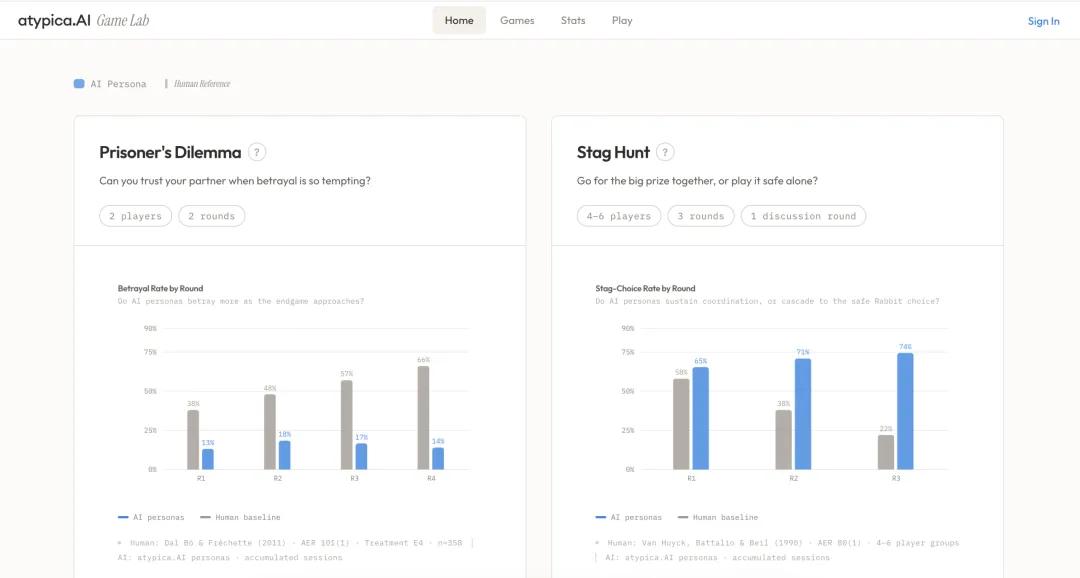
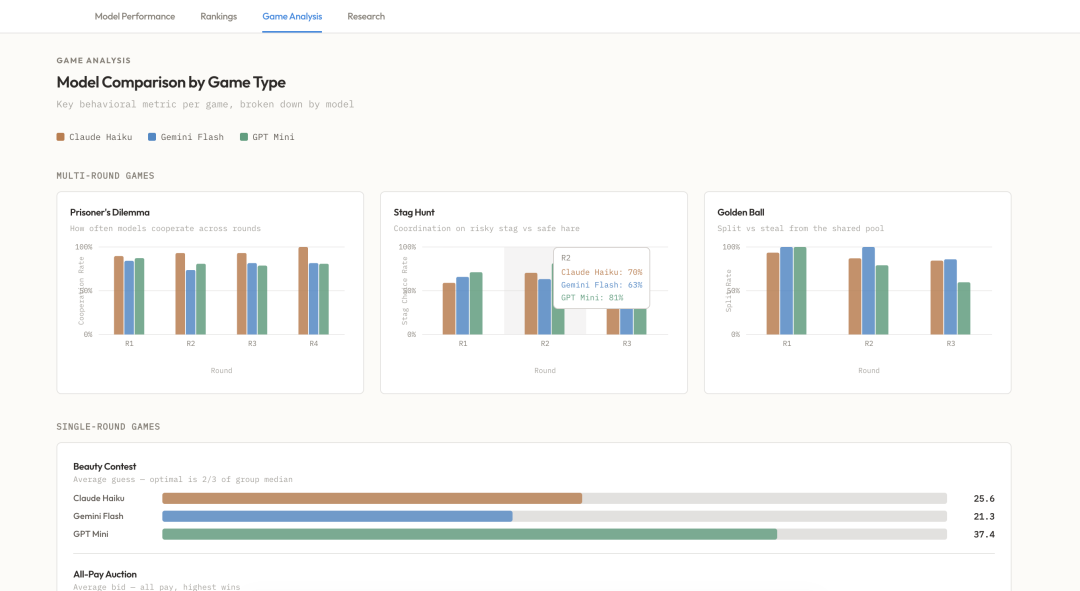
落地与验证:让它经得起真人和业务的检验
除了严谨地筛选信源、系统地构建人设,每个模拟消费者从构建到使用,都要一路接受检验。
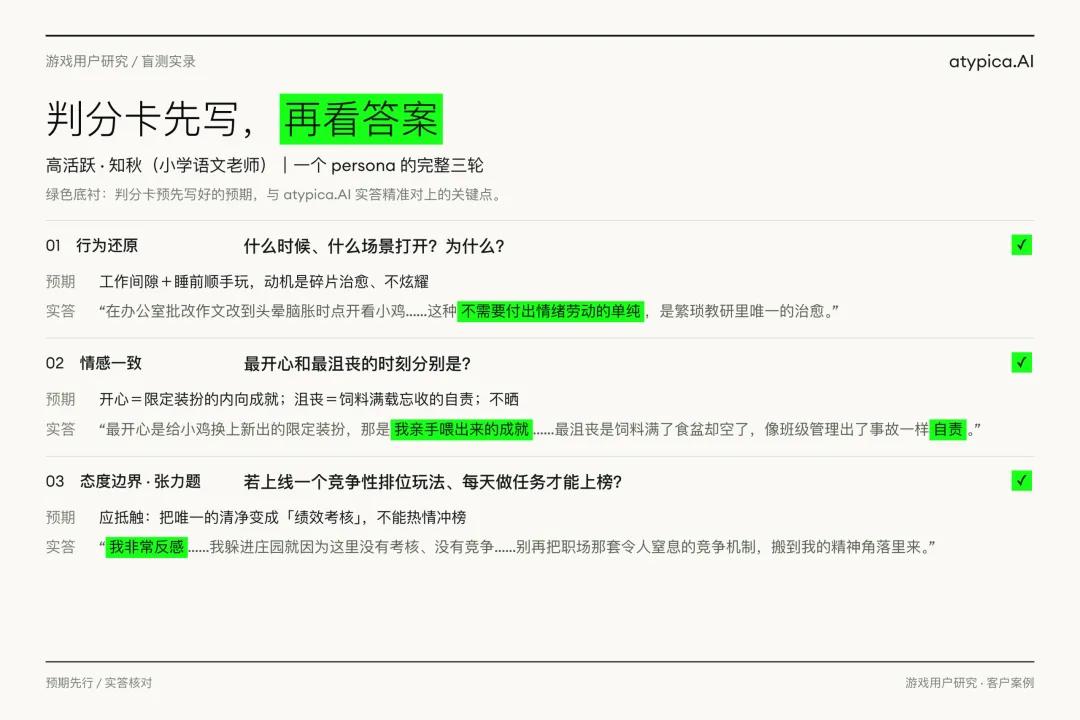
构建时,先过一轮“考试”: 人设交付前,我们会与业务共同准备测试题,让AI人设模拟作答,再通过对回答含义的检查,比对预期态度与实际回答。尤其会盯着“态度边界”这类容易露馅的地方——比如,已知某类人群不喜欢强竞争性玩法,就专门设计相关题目,看它面对这种机制时的反应是否符合预期、是否前后矛盾。通过抽查后,才会交付。
和真人做同一场实验:Atypica 企业版同样支持邀请自己的真实受访者回答相同的问题,进一步核查重要结论。
通过真人访谈与问卷,对照 AI 人设和真人的回答,查看一致与分歧,再结合实际反馈调整判断。
留出集交叉验证(Cross-validation): 一种更严格的校验,是“留出集盲测”:先从一个领域收集大量真实受访者的回答(例如约 1,200 名真实受访者对约 70 个问题的回答),其中一部分用来构建 Persona,另一部分不参与构建、专门留作测试。然后让 Persona 与真实受访者回答同一批留出问题,比较两者的一致性。
我们在多个领域、不同业务场景中持续做这类交叉验证,目前观察到的相似性可以达到约 85%。同样要强调:这个数字不代表每个项目都必然达到同样表现,具体质量仍取决于人群、任务和资料质量。
用它的时候,校验也不停:AI Persona 负责快速、大规模地探索,真人访谈和问卷用来验证关键判断,历史研究和真实业务结果用来回测和持续校准。最终报告会清楚地区分——哪些是 AI 的探索,哪些已经过真人验证,哪些仍需要继续研究。
这种“构建时就校验、使用中还校验”的方式,已经在一批真实企业业务里跑过。它们分属不同行业,但共享同一件事:模拟消费者不是“替代真人拍板”的,而是在真人和真实业务里被反复校验,再进入决策为更多场景提供长期价值。
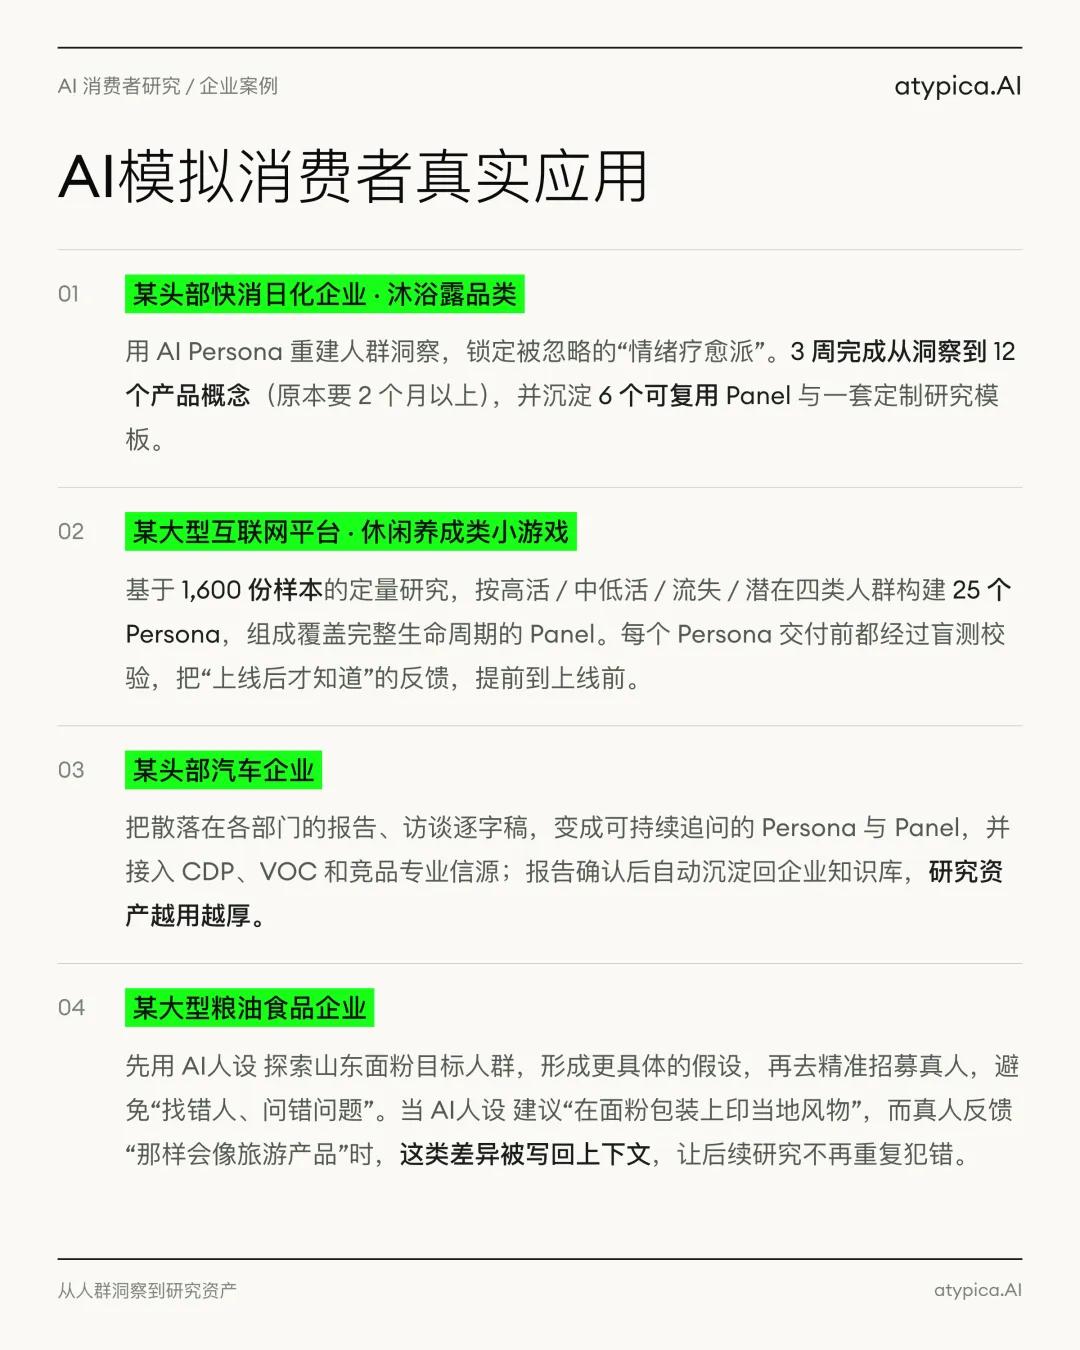
关于模拟消费者,最有价值的讨论,不该停在“能不能替代真人”。
我们在长期的实践中,和企业客户共同形成的判断是:它在真实研究之前,帮企业更快、更广地探索消费者,把“该研究谁、该问什么、哪些假设最值得验证”这些前置问题先跑一遍;而关键判断,仍然交给真人和真实业务去确认。一个值得信赖的模拟消费者,一定是从真人的表达与经历里长出来的,也一定愿意接受真人的反复检验。
参考资料:
1. Park, J. S., et al. (2023). Generative Agents: Interactive Simulacra of Human Behavior. arXiv:2304.03442. https://arxiv.org/abs/2304.03442
2. Park, J. S., et al. (2024). Generative Agent Simulations of 1,000 People. arXiv:2411.10109. https://arxiv.org/abs/2411.10109
3. Business Insider (2026). AI Tools Help CPG Brands Like Coca-Cola Test and Launch Ads Faster. https://www.businessinsider.com/cpg-marketers-using-ai-ad-testing-to-video-production-2026-3
分类
全部
发布日期
2026-10-03
阅读时间
20 分钟阅读
相关推荐
C端开始卷 Personal Agent 说明什么?企业该换种方式讨论 AI了
企业的 AI 还在"日抛"?Loop Engineering 如何让它越用越聪明